
تئوری مبنی بر اینکه رابط کاربری صوتی، آیندهی بزرگ فناوری است، اخیراً انرژی زیادی گرفته است. سرمایهگذاران میلیاردها دلار به استارتاپهای هوش مصنوعی صوتی سرازیر کردهاند؛ از سازندگان مدلهای زبانی گرفته تا ارائهدهندگان خدمات پشتیبانی مشتری بیزینسی، تا ابزارهای یادداشتبرداری هوشمند. به نظر میرسد هر هفته مدلی جدید یا ابزاری تازه منتشر میشود که ادعا دارد صدای کاملاً انسانی دارد و مثل یک فرد واقعی گفتوگو میکند. اما واقعیت چیست؟ آیا واقعاً به آن لحظهی سرنوشتساز که همه منتظرش هستند، رسیدهایم؟
پایان ماجرا نیست؛ چالشهای پیشِرو
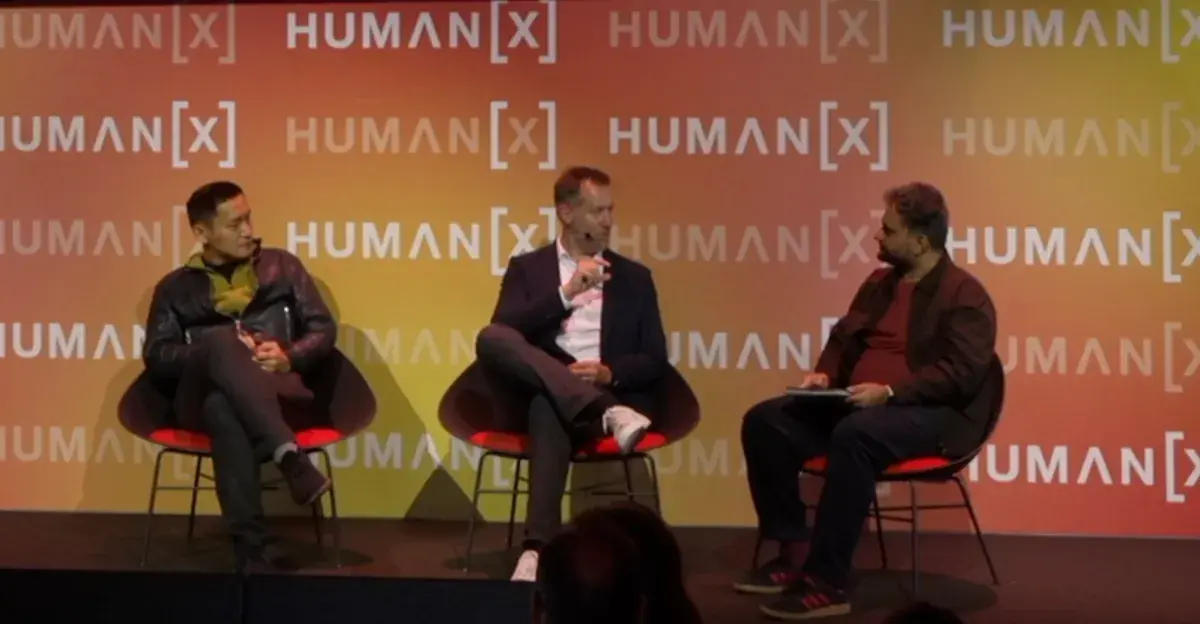
شن ون، مدیر فنی (CTO) پلتفرم هوش مصنوعی صوتی سازمانی PolyAI معتقد است که با وجود انتشار مدلهای تمامدوطرفه (Full-duplex) که میتوانند در حین گوش دادن، صحبت کنند، هنوز به آن «لحظه ChatGPT» نرسیدهایم. او در کنفرانس HumanX توضیح داد که رسیدن به ساختار مدلهای تمامدوطرفه یک نقطه عطف است، اما گره اصلی الان سرعت استدلال است.
و این یعنی مدلها باید بتوانند پاسخها را بسیار سریع و بدون تأخیر قابلتوجه بازیابی کنند تا حس طبیعیبودن گفتوگو حفظ شود. ون اضافه کرد که عاملهای هوشمند در خدمات مشتری نباید رباتیک به نظر برسند. بلکه باید بهگونهای با کاربر ارتباط برقرار کنند که اعتماد لازم برای حل مسئله ایجاد شود. پیشبینی او این است که وقتی کیفیت صدا به سطح مطلوب برسد و مشتری در چند دور اول گفتوگو حاضر به تعامل باشد، بهتدریج اعتماد بیشتری شکل میگیرد و افراد متوجه میشوند دیگر نیازی به صحبت با یک انسان ندارند تا مشکلشان حل شود.
فراتر از یک چتبات پرسش و پاسخ
آلکس گِی، مدیر بازاریابی (CMO) شرکت Otter که در حوزه یادداشتبرداری هوشمند نشستها فعالیت میکند، رویکرد متفاوتی دارد. او معتقد است شناسایی گوینده، درک نیت و وارد کردن اطلاعات با دانش سازمانی، گامهای کلیدی برای اتوماسیون واقعی هستند. Otter حتی در حال کار روی «دوقلوی دیجیتال» است که نمایندهی افراد در جلسات خواهد بود.
برای گِی، نکته حیاتی این است که خروجی صوتی این آواتارها، همان احساسات و لحن گفتوگوهای انسانی را بازتاب دهد. او میگوید: «به جلسات فعلی خود فکر کنید؛ بهترین گفتوگوها آنجا شکل میگیرد که بحث، استراتژی و حس رابطه وجود دارد. اگر نتوانید این حس را با یک آواتار ایجاد کنید، صرفاً یک چتبات پرسش و پاسخ دارید، نه یک همکار هوشمند.»
دقت در درک و شفافیت برای جلب اعتماد
با وجود پیشرفتهای چشمگیر، هوش مصنوعیهای صوتی هنوز در درک کامل کاربران و ارائه خلاصههای دقیق مشکل دارند. ون معتقد است مدلهای تشخیص خودکار گفتار (ASR) اغلب کلمات کلیدی مهم را از قلم میاندازند که این موضوع درک بافت کامل گفتوگو را خراب میکند.
گِی هم با این دیدگاه موافق است و تأکید میکند که برای Otter، ترانسیپت (نسخهنویسی) هرگز مقصد نهایی نبوده است؛ این فقط لایهای است که بهرهوری از طریق آن افزایش مییابد. اما اگر نسخهنویسی اولیه دقت کافی نداشته باشد، تمام اقدامات پیگیر بعدی از پایه خراب میشود. حتی یک خطای کوچک در زمان انجام عملیات، باعث از دست رفتن اعتماد کاربران به پلتفرم میشود.
شفافیت در تعامل با هوش مصنوعی
یک مسئله مهم دیگر، شفافیت است. ابزارهای جدید باید به صراحت به مشتریان اعلام کنند که در حال مکالمه با یک هوش مصنوعی هستند یا صدایشان ضبط شده است. Otter میگوید هدفش ایجاد اعتماد در شرکتکنندگان جلسات است؛ حتی اگر بات در جلسه حضور نداشته باشد، روشهایی مانند اعلان به همه در چت درباره ضبط جلسه را میتواند استفاده کند. ون هم تأکید میکند که در تماسهای سازمانی، بسیار حیاتی است که مشخص شود مخاطب با یک هوش مصنوعی در ارتباط است، نه یک انسان.



نظر، سوال یا تجربه خود را درباره این مطلب با سایر کاربران اوکالا به اشتراک بگذارید.